API REST de SEO Técnico: Cómo Automatizar Auditorías, CI/CD y Dashboards BI en Agencias
Escrito por Equipo SEOdiag · Publicado el 2026-08-12
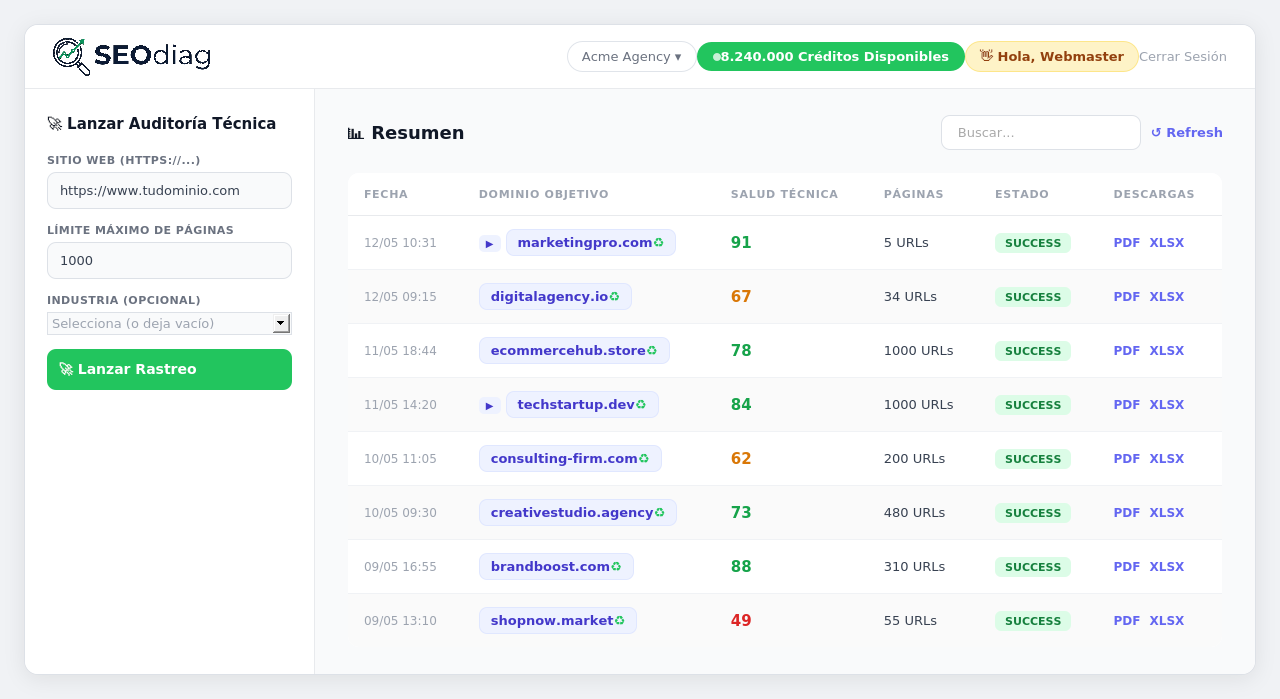
Cuando una agencia SEO o un equipo de ingeniería in-house supera los 20 o 50 dominios gestionados en simultáneo, ejecutar rastreos manuales desde un navegador o depender de licencias de escritorio como Screaming Frog se convierte en un cuello de botella operativo.
Hoy anunciamos la publicación oficial de la documentación de la API REST de SEOdiag junto con la habilitación dedicada del acceso programático para nuestros planes Agency y Enterprise. Con esta arquitectura, cualquier equipo técnico puede transformar el motor de rastreo cloud de SEOdiag en una pieza integrable dentro de sus propios pipelines de datos, sistemas CRM y flujos de despliegue continuo (CI/CD).
¿Por qué automatizar el SEO técnico mediante una API REST?
Las auditorías manuales suelen ser reactivas: alguien nota una caída de tráfico en Google Search Console, abre un rastreador y descubre que un despliegue de hace dos semanas introdujo una etiqueta noindex o rompió las canónicas de una categoría clave.
Integrar una API de rastreo técnico cambia el paradigma de reactivo a preventivo en tres frentes:
- Quality Gates en CI/CD (GitHub Actions / GitLab CI): Dispara un rastreo automático sobre el entorno de staging o producción inmediatamente después de cada
git pushpara verificar que ninguna plantilla clave devuelva errores404/500ni haya perdido su estructura de encabezadosH1. - Ingesta en Data Warehouses y Dashboards BI: Alimenta tablas en BigQuery, Snowflake, Looker Studio o Power BI combinando la evolución del Score de Salud SEO (0-100) con métricas de negocio (conversiones, ingresos orgánicos y presupuesto de rastreo).
- Onboarding y Preventa Comercial Automatizada: Si tu agencia capta leads mediante un formulario web, tu backend puede disparar un escaneo vía API en segundo plano y generar un diagnóstico técnico listo para la llamada comercial.
Comparativa: Rastreadores de Escritorio vs. API Cloud de SEOdiag
| Dimensión Operativa | Crawlers de Escritorio (CLI Local) | API Cloud Enterprise (Tradicional) | API REST de SEOdiag (Agency / Enterprise) |
|---|---|---|---|
| Infraestructura | Consume RAM/CPU local o requiere mantener servidores propios | 100% Cloud (contratos anuales de +$500/mes) | 100% Cloud sin mantenimiento de infraestructura |
| Evasión de WAF / Cloudflare | Bloqueos frecuentes por IP residencial/oficina | Requiere configuración manual de proxies o whitelist | Evasión inteligente integrada con perfiles TLS y desbloqueo bajo demanda |
| Aislamiento Multi-Cliente | Carpetas locales separadas por proyecto | Subcuentas complejas | Cabecera nativa X-Workspace-ID por petición HTTP |
| Modelo de Costos | Licencia anual por asiento + servidor | Contratos corporativos rígidos | Incluida en planes Agency ($99) y Enterprise ($159) |
| Datos Extraíbles | Exportación CSV manual o vía scripts locales | REST / GraphQL | JSON paginado (URLs, Issues, Score, Speed, Historial) |
Arquitectura de Autenticación y Multi-Tenancy (X-Workspace-ID)
La API de SEOdiag utiliza tokens JWT (JSON Web Tokens) firmados. Al autenticarte contra POST /auth/login desde una cuenta con nivel Agency o Enterprise, la respuesta JSON entrega directamente tu access_token (válido por 12 horas) para que puedas cachearlo en tu servicio o secret manager:
curl -X POST "https://seodiag.com/auth/login" \
  -H "Content-Type: application/json" \
  -d '{
    "email": "ingenieria@tuagencia.com",
    "password": "TU_PASSWORD_SEGURO"
  }'
Para agencias que administran múltiples marcas o unidades de negocio, cada llamada posterior puede especificar sobre qué espacio de trabajo operar enviando el encabezado X-Workspace-ID. Esto garantiza un aislamiento estricto de datos y créditos entre clientes sin necesidad de abrir sesiones separadas.
Flujo Completo en Python: Disparar, Monitorear y Extraer Hallazgos
A continuación mostramos un ejemplo real en Python para lanzar una auditoría controlada tras un despliegue a producción, aguardar su finalización y verificar que el puntaje de salud técnica no caiga por debajo del umbral definido por el equipo:
import time
import requests

BASE_URL = "https://seodiag.com"
HEADERS = {
    "Authorization": "Bearer TU_ACCESS_TOKEN_JWT",
    "X-Workspace-ID": "23",
    "Content-Type": "application/json",
}

# 1. Iniciar rastreo técnico acotado a 500 URLs tras el deploy
resp = requests.post(
    f"{BASE_URL}/crawl",
    headers=HEADERS,
    json={"url": "https://cliente-ecommerce.com", "max_urls": 500},
    timeout=30,
)
resp.raise_for_status()
job_id = resp.json()["job_id"]
print(f"🚀 Auditoría iniciada (job_id={job_id})")

# 2. Polling no bloqueante cada 15 segundos
while True:
    status_data = requests.get(f"{BASE_URL}/status/{job_id}", headers=HEADERS, timeout=15).json()
    if status_data["status"] in ("completed", "failed", "canceled"):
        break
    print(f"⏳ Fase: {status_data.get('stage')} | URLs: {status_data.get('crawled_count')}")
    time.sleep(15)

# 3. Validar Score de Salud y recuperar issues críticos
summary = status_data.get("summary", {})
score = summary.get("health_score", 0)
print(f"✅ Auditoría completada — Health Score: {score}/100")

if score < 80:
    issues = requests.get(f"{BASE_URL}/crawl/{job_id}/issues", headers=HEADERS, timeout=15).json()
    print(f"⚠️ Alerta CI/CD: Score bajo ({score}). Categorías afectadas: {list(issues['issues'].keys())}")
Endpoints Principales para Equipos de Datos y BI
En la nueva Guía de API REST e Integraciones detallamos todos los esquemas de entrada y salida. Los puntos de conexión más utilizados por nuestros clientes Agency y Enterprise incluyen:
GET /projects: Inventario completo de dominios auditados en el workspace, con su último puntaje de salud, cantidad de URLs rastreadas y estado de monitoreo programado.POST /crawlyGET /status/{job_id}: Orquestación asíncrona de rastreos bajo demanda con control granular del límite de páginas (max_urls) y seguimiento en vivo de etapas (Discovery, Crawling, Speed & Analysis).GET /crawl/{job_id}/urls: Extracción paginada (hasta 500 URLs por llamada) con filtros por código de estado (status_code), estado de indexabilidad (indexable_status) o búsqueda libre (search). Incluyettfb_ms,title,h1,canonical,word_county profundidad de clic (depth).GET /crawl/{job_id}/issues: Diccionario consolidado de hallazgos técnicos clasificados por regla SEO y severidad.GET /history/detail?url=...: Serie temporal histórica de un dominio para graficar tendencias de salud técnica, errores4xx/5xx, páginas no indexables y tiempos de respuesta del servidor en Looker Studio o Tableau.
Seguridad, Rate Limiting y Gobernanza por Tier
Para garantizar la estabilidad de nuestra infraestructura de colas distribuidas y proteger los recursos de todos los workspaces:
- Exclusividad para Planes Superiores: El uso programático mediante cabeceras
Authorization: Bearerestá reservado a los planes Agency y Enterprise. Las cuentas en niveles inferiores reciben una respuesta explícita403 Forbiddeninvitando a actualizar su suscripción. - Límites de Concurrencia y Tasa: El inicio de nuevos rastreos (
POST /crawl) cuenta con un rate limit de seguridad de 10 solicitudes por minuto, recomendándose un intervalo de polling de 10 a 15 segundos sobre/status/{job_id}. - Conservación Estricta de Créditos: Si un rastreo falla por causas ajenas o el servidor de destino rechaza la conexión inicial, el sistema de contabilidad transaccional de SEOdiag conserva tus créditos intactos.
Puedes consultar la referencia técnica completa en español en /docs/api-integraciones-guia.html o en inglés en /en/docs/api-integrations-guide.html, y revisar el resto de mejoras recientes del motor en nuestro Changelog oficial.